公共數位服務遭 DDoS 攻擊:政府機關如何判斷服務中斷是否正在擴大?
挪威數位化局(Digdir)在 2026 年 8 月 25 日發布通報,旗下多項政府共用的關鍵數位服務自 8 月 24 日凌晨起遭到分散式阻斷服務攻擊(DDoS)。受波及的系統包括挪威民眾常用的身分驗證入口 ID-porten、MinID、負責機關與企業資料交換授權的 Maskinporten,以及政府一站式入口網站 Altinn。
攻擊發生時,部分服務出現短暫斷線,但更多時間是民眾反映登入極度緩慢、甚至卡在驗證畫面。雖然親俄駭客團體 Server Killers 隨後宣稱犯案,但在正式的數位鑑識調查報告出爐前,這類網路宣稱依然只能當作攻擊者單方說法,不能直接作為國家級威脅的正式歸因。
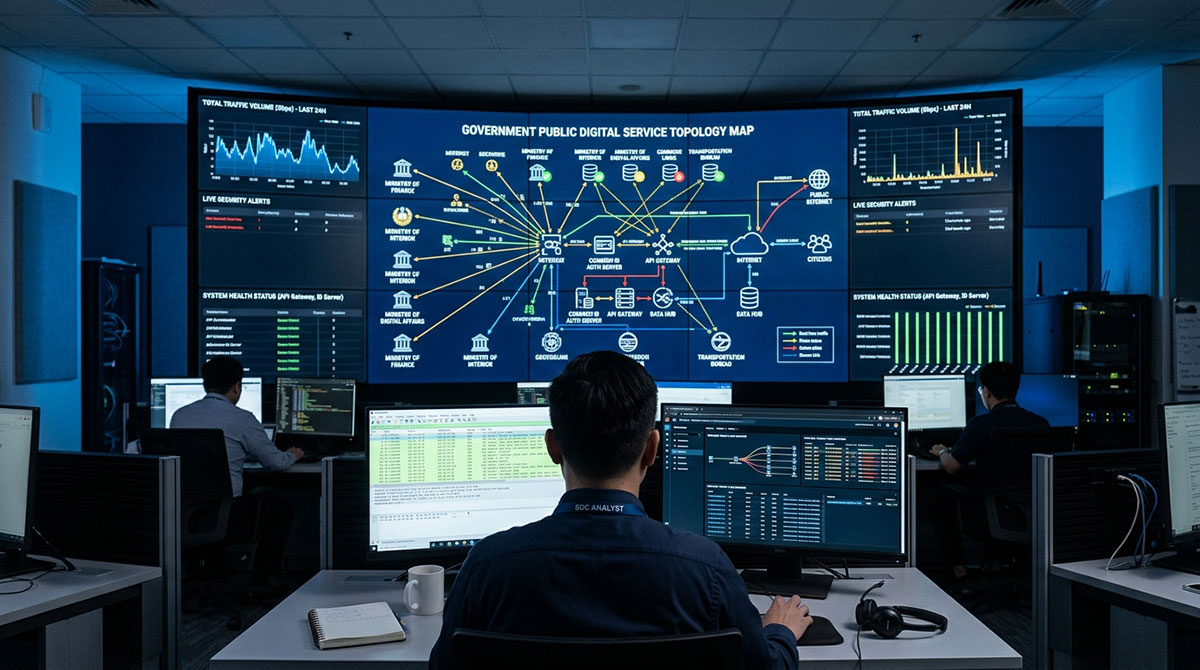
這起事件給台灣各政府機關與關鍵基礎設施維運團隊一個很實際的警訊:當系統開始出現連線警報時,最危險的心態就是「反正只是流量變大,等對方打完就好」。現場指揮官真正要做的是在第一時間精準判讀——這場斷線到底只卡在最外層的網站首頁,還是已經沿著共用身分、API 資料鏈和委外廠商,一路往內部公共服務擴大?
面對突發的高流量癱瘓,第一線資安與維運團隊可以依序透過以下五個節點來排查與評估。
先抓出是單點故障,還是共用元件被波及
狀況發生時,最容易讓現場亂成一團的,就是各業務單位紛紛回報「我的網站開不起來」。這時候不能頭痛醫頭、盲目去重啟單一主機,而是要先把架構清單拉出來,盤點身分登入、電子簽章、資料交換(API)、DNS、CDN、電信網路與雲端主機之間的依賴關係。
Digdir 這次的狀況就是典型的連鎖效應:因為很多政府單位都串接了 ID-porten 作為共用身分驗證入口,加上底層走同一套營運環境,表面看起來是稅務、醫療、福利等多個網站同時當機,實際上出問題的只是中央那一套身分交換元件。
因此,指揮官要做的第一步,是立刻建立一份受影響服務清單,標示清楚各系統現在是「完全不可用、延遲緩慢、降級服務、還是正常」,並從共同相依的環節找出問題源頭。正如我們在分析企業架構關鍵營運依賴點與系統相依性時強調的,往往讓營運癱瘓的不是前端門面,而是卡在深層的共用節點上。
拉出多維度時間線,確認中斷是不是在持續擴大
光看單一時間點的告警,很難知道事情是正在好轉還是繼續惡化。維運小組應該把進站流量波形、HTTP 錯誤率(4xx/5xx)、登入驗證延遲毫秒數、民眾進線客服的頻率、電信端流量清洗狀態以及主機重啟時間,全部對齊在同一個時間軸上,並且在應變期間維持每 15 到 30 分鐘更新一次。
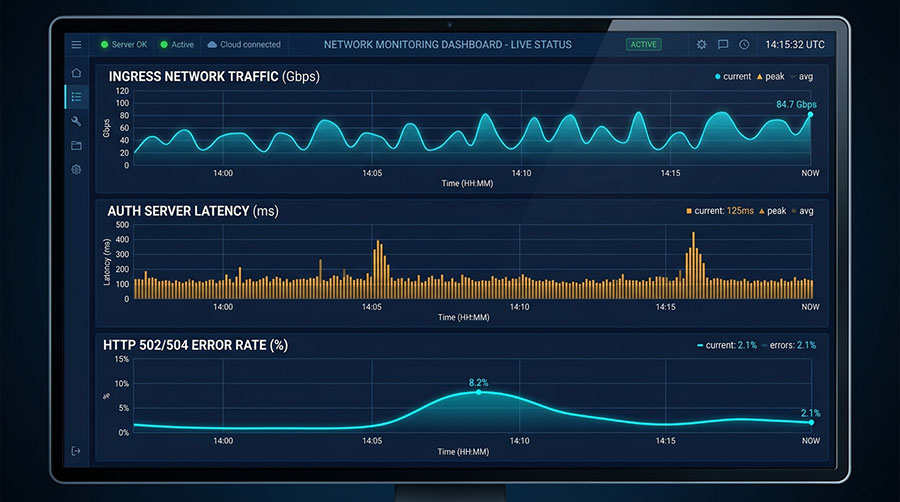
如果時間軸畫出來發現:受影響的系統數量越來越多、剛重啟恢復的服務沒幾分鐘又掛掉,或是不同對外線路的錯誤率同時飆高,這代表中斷正在擴散,必須立刻拉高應變層級。這份時間線也是給長官和公關發言人最清楚的決策參考,能快速決定是否該切換備援機制、要不要調度客服支援,以及什麼時候向民眾公開服務狀態。
把 DDoS 攻擊與帳號入侵、資料外洩分開驗證
系統被流量灌爆時,團隊常常會被恐慌牽著走:要麼害怕「是不是資料庫被偷光了」,要麼掉以輕心覺得「只是被 DDoS 攻擊,資料沒事」。
但在實際的進階攻擊手法中,駭客很常拿大規模流量當煙霧彈,藉此轉移資安團隊的注意力,暗地裡進行滲透。現場一定要把調查路線拆成三條獨立的證據鏈:
- 邊界網路軌:核對流量型態、封包特徵、來源 IP 分布與邊界防禦狀況。若平日有落實 Cloudbric WAF 在日常維運與流量切換情境 的設定標準,就能在幾分鐘內分出這些請求是偽造的惡意流量,還是民眾因為系統變慢而反覆重新整理造成的尖峰。
- 身分權限軌:檢查管理員後台、OAuth 與 API 權限,看看這段時間有沒有異常的登入成功紀錄、新增的授權帳號或是 Token 被大量調用。
- 後端資料軌:清查核心資料庫的讀取總量、大量匯出行為或異常排程。
把證據分開看,才能避免慌亂中把單純的系統當機誤判成個資外洩,也不會因為全副精神都在處理清洗流量,反而漏看了悄悄溜進後台的真正威脅。
把委外維運廠商也放進應變範圍裡
Digdir 在後續說明中特別提到,這次攻擊也直接波及了協力維運夥伴 Vivicta 的基礎設施。這點出了一個很現實的問題:現在政府機關的數位服務邊界,早就跟外部供應商綁在一起了。
機關在平日的合約與防汛演練中,就要把廠商的應變責任定義清楚:
- 誰有權限決定開啟流量清洗或啟動限流措施?多久要生效?
- 網路路由切換由誰執行?誰負責驗證線路品質?
- 廠商要提供哪些日誌資料?多久要回報一次處理進度?
- 遇到事件時,技術細節由廠商整理,但對外說明的時間點由機關全權主導。
如果委外廠商在事發後只能丟一句「目前主機重啟中」或「服務已恢復正常」,卻交代不出流量特徵報告、影響範圍和後續防範措施,對機關來說就是一個不可控的資安盲點。
用嚴謹的指標決定事件是不是真的落幕
很多時候,維運人員看到機關首頁打得開,就急著回報「狀況解除」,這往往是下一次斷線的開始。
大部分服務在遭受攻擊後,只要民眾開始大量湧入重新登入,脆弱的後端系統很容易再度被壓垮。真正的恢復必須通過完整的多重驗證:身分登入、電子簽章、資料庫讀寫、跨機關 API 拋接、高負載承載力,以及第三方金流或串接服務是否正常。
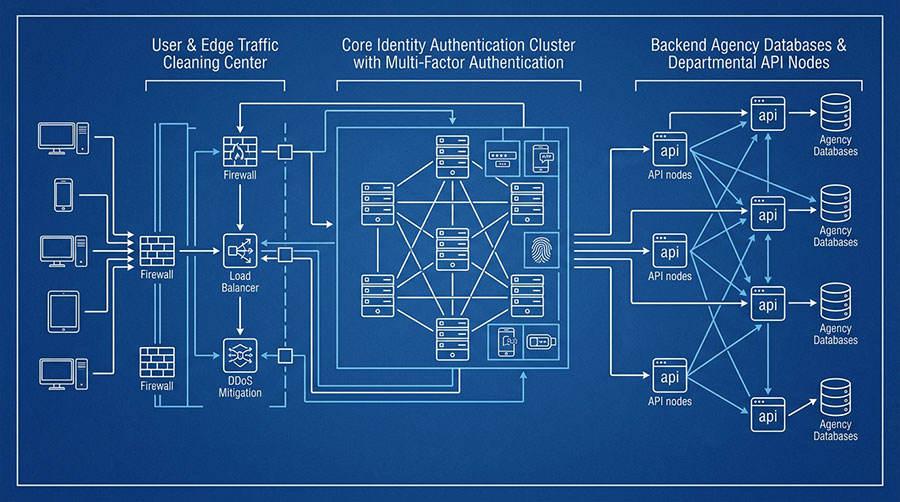
除了各項效能指標(如延遲毫秒數、連線逾時率)要回落到平常的基準線之外,應變期間臨時掛上的防禦規則(例如強制圖形驗證碼、暫時封鎖特定網段)也必須確認退場時程。事件結案後,這整份相依架構圖、時間判定流程與廠商處置紀錄都要完整留存。這就像資安管理團隊在落實以在野威脅情資排定修補優先序時的務實思維一樣,所有防護處置都必須經過驗證,下一次才能真正縮短復原時間。
給公部門與大型單位的採購檢核清單
下次在採購 DDoS 防護、WAF 或雲端代管服務時,除了看廠商宣稱能擋幾百 Gbps 的頻寬之外,更要深入問清楚這些維運細節:
- 核心身分服務隔離:當前台被攻擊時,共用的身分登入模組能不能平順降級,避免拖垮所有後續服務?
- 備援接管演練時效:宣告主機異常後,切換到備援線路需要幾分鐘?平時是否有真正實測過?
- 日誌無縫串接:清洗中心與 WAF 攔截到的日誌,能不能即時送進內部的資安監控中心(SOC)一起分析?
- 獨立的服務狀態頁:對民眾公告的即時狀態頁(Status Page),是否有獨立架設在完全不同的網域與主機?千萬不要發生官網掛掉時、連公告也貼不出去的窘境。
常見問題(FAQ)
參考來源資料(Sources)
- Digdir 官方公告:Digdir stabiliserer løsningene etter dataangrep
- Digdir 服務狀態即時說明:Tjenestenektangrep mot Digdir sine løsninger
- The Record 外媒報導:Massive DDoS attack disrupts Norway’s government digital services
- BleepingComputer 報導:Massive DDoS attack disrupts Norway’s government digital services