SAST 不是掃出報告就結束:導入原始碼檢測必備的 5 個治理流程
在很多企業裡,導入 SAST(Static Application Security Testing,靜態應用程式安全檢測)的過程常被簡化成一件很單純的事:買了一套工具,把程式碼倒進去,等它跑出一份厚厚幾百頁的 PDF 報告就算交差。
但實務上,真正的挑戰往往在報告印出來之後才開始。資安窗口把塞滿各類警示的報表整包轉寄給開發主管,工程團隊平時光是應付產品排程的 Sprint 需求就已經焦頭爛額,看到滿滿的弱點清單與疑似誤判,根本不知道從何看起。最後,這份報告就只能靜靜躺在信箱或 Jira 的角落,直到下次稽核來臨。
對企業買方來說,檢驗 SAST 投資效益的標準,從來不是「這份報告有幾百頁」或「掃描引擎跑得有多快」,而是工具抓出問題後,能不能自動分派給對應的負責人、在日常開發節奏內完成修復、即時進行複測確認,並留下能讓稽核信服的處置紀錄。
如果這條管線沒有打通,SAST 很容易淪為被開發團隊集體忽視的「垃圾告警清單」。在規劃將檢測落地前,請務必先確認內部是否具備以下 5 個關鍵流程條件:
1. 先定義結果交給誰:別讓告警寄到「無人認領」的共用信箱
很多導入專案之所以卡住,是因為缺乏系統與專案負責人的對應架構。工具一跑完,掃描結果全部灌進某個資安共用信箱,最後得靠資安人員逐條人肉檢視程式碼,猜測這段邏輯是哪位工程師寫的,再手動複製貼上到工單系統。
就像企業在規劃滲透測試時必須釐清檢測邊界與資產清單一樣,導入 SAST 前也必須先把程式碼儲存庫、所屬專案與系統負責人清點乾淨。在工具 PoC 階段,請務必請廠商實機示範:
- 系統抓到 SQL Injection 或硬編碼金鑰等高風險弱點時,能否根據 Git Blame、CODEOWNERS 或儲存庫設定,自動開立 Jira、GitLab Issues 或 Azure DevOps 工單?
- 工單內容是否已完整帶出專案名稱、檔案路徑、精確行號與弱點類型(如 CWE 標籤)?
- 主管能否在介面上即時掌握有哪些問題已經逾期(Overdue)未處理?
如果分派流程還得依賴人工搬移資料,專案規模一旦放大到數十個儲存庫,追蹤機制很快就會全面失控。
2. 把修正責任放進開發節奏:依風險等級制定合理的中斷規則
原始碼檢測最忌諱在上線前一刻才拿出來突襲開發團隊。這往往會讓團隊陷入兩難:不是為了趕準時交付而被迫簽核放行,就是為了一個低風險警示硬生生卡住整個發布排程,造成跨部門的嚴重摩擦。
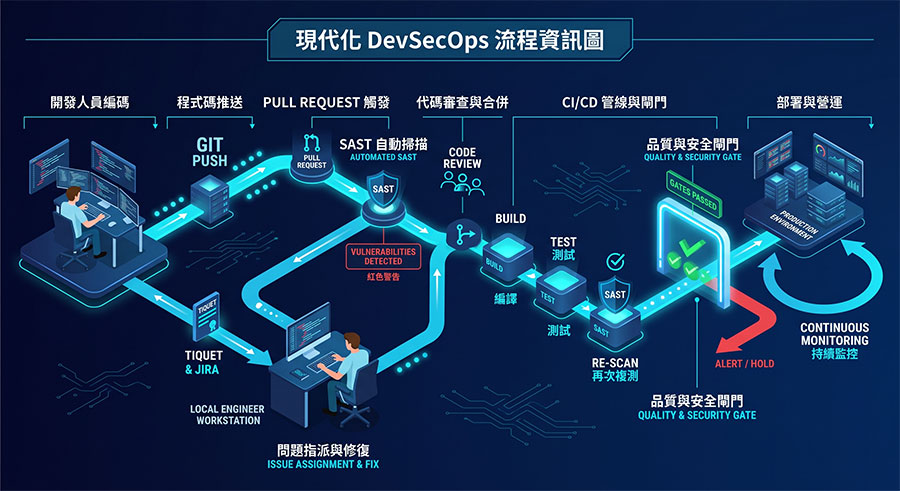
比較務實的做法,是讓安全檢查自然地向左移(Shift-Left)。確認工具能否整合進工程師日常習慣的 IDE 環境,或在發起 Pull Request(PR)/ Merge Request(MR)時自動執行增量掃描,並在 CI/CD 流程中設定合理的阻擋條件(Quality Gate)。
我們不必在每次打包時把所有警示都當成緊急事件。如同資安維運中參考 CISA KEV 建立已遭利用弱點的修補優先級 的思維,代碼檢測也應先聚焦在最致命、容易被外部利用的弱點(例如認證缺陷、越權存取或外部輸入未過濾),並針對這些項目設定強制阻擋條件。評估工具時,建議挑選一個真實專案實測:「從 PR 觸發掃描、發現弱點、分派修正到再次通過合併」,整體流程到底耗費多少時間,而不是只盲目比較單純的掃描運算速度。
3. 驗收一定要包含複測:缺乏驗證的「已修正」很難過關
工程師修改了程式碼、送出了 commit,並不代表弱點就真的被排除了。有些時候,程式碼的改動可能只是繞過了特定字串的比對規則,甚至在邏輯上衍生出其他安全盲點。
這也是為什麼在現代弱點管理中,非常強調針對已知弱點的暴露面驗證與複測機制。在 SAST 流程裡同樣如此:當開發人員提交新版本後,系統應能自動針對變更範圍重新驗證,並將原始結果、修復版本、驗證時間與驗證者完整留存。
在評估採購方案時,有兩個細節一定要問清楚:
- 複測成本:複測是系統自動觸發,還是需要手動設定?是否會被計入額外的掃描額度或收費?
- 跨分支追蹤:同一個弱點在不同 feature 分支合併時,系統能否精確辨別,還是會被當成新問題重覆計算?
缺乏客觀複測佐證的「工程師口頭表示已修正」,在面對內外部稽核或資安事故調查時,很難具備說服力。
4. 例外不能變成永久放行:為每一筆豁免加上「到期日」
在真實的企業開發環境中,誤判(False Positive)、老舊系統結構暫時無法更動,或是第三方套件本身的限制,都是很常見的現實狀況,也因此勢必會需要「例外處理(Suppression / Exception)」。
然而,許多系統只提供一顆單純的「Ignore」或「忽略」按鈕。工程師按下去之後,這筆問題就被打入冷宮,實際上只是把風險藏進報表看不見的地方。
一套健全的例外管理流程,必須包含以下要件:
- 明確記錄原因:說明為什麼無法立刻修復,或是判定為誤判的具體依據。
- 補償性控制:是否有 WAF 規則、網路隔離或其他措施在外部進行防禦。
- 分級審核與到期提醒:中低風險可由 Tech Lead 核准,高風險必須由資安團隊與系統負責人共同簽核;且所有例外都必須強制設定到期日(例如 60 或 90 天)。
時間一到,系統應自動喚醒該問題重新評估,避免暫時的妥協演變成永久的安全漏洞。
5. 留痕要能回答治理問題:不要只算「掃了幾行 code」
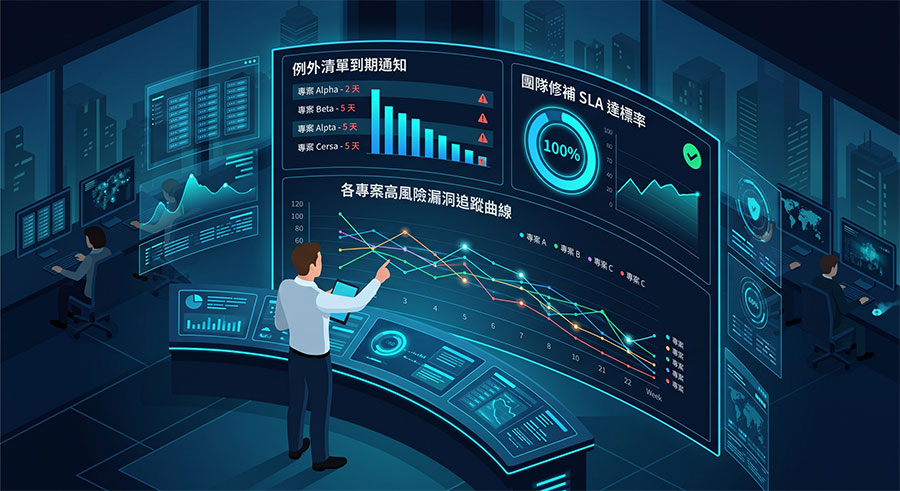
對資安長或工程副總來說,每個月最關心的指標絕不是「這個月我們掃描了幾千萬行程式碼」,而是組織整體的風險輪廓到底長什麼樣子:
- 哪幾個關鍵微服務還掛著未解決的高風險弱點?
- 各團隊的平均修復時間(MTTR)有沒有隨著流程熟悉而縮短?
- 有多少例外項目即將到期?哪些單元是持續拖延的常客?
導入評估時,務必檢視工具的儀表板與報表能不能按照專案、嚴重度、負責團隊與修復期限來篩選,並能快速匯出給主管機關或客戶稽核使用。若企業內部已建置了集中弱點管理平台或 SIEM,更要先確認雙方的 API 能否順利拋轉資料,確保資安責任與欄位定義完全對齊。
企業該如何規劃導入:從 2~4 週的實戰試點開始
如果你的團隊正準備引進 SAST,建議不要一開始就把全公司幾十個專案一口氣倒進去。比較穩健的節奏,是挑選一套主流技術棧、找兩到三個配合度高且具代表性的服務團隊,展開 2 到 4 週的試點(PoC):
- 第 1 週:確認程式碼涵蓋範圍,調校掃描規則,把無效的誤判雜訊壓下來。
- 第 2 週:串接 Git 與 CI/CD 流程,測試自動派工工單與 Pull Request 閘門。
- 第 3~4 週:實測工程師修復後的複測機制、例外申請與審批流程,最後檢驗管理報表是否能回答經營階層的問題。
將驗收標準量化為流程指標——例如「高風險弱點於幾小時內完成指派」、「PR 階段修補後幾分鐘內完成增量複測」、「例外豁免多久必須重審」。
一套 SAST 工具的真正價值,不在於它又抓出多少頁的告警,而在於它是否能幫助團隊縮短「從發現漏洞到修復關閉」的週期時間。
常見問題(FAQ)
別讓原始碼檢測,只停留在產出報表的階段
導入 SAST 的核心目的,從來不是為了累積更多未處理的待辦告警,而是讓安全弱點能被精準分派、有效修復與合規留痕。
專業團隊能協助企業將代碼安全檢測無縫融入現有開發節奏,打造兼顧敏捷交付與資安防護的軟體供應鏈體系。